Produktionsreife Software Entwicklung

Software wird entwickelt und irgendwann läuft diese in produktiven Verhältnissen. Doch was heißt es wirklich produktionsreif Software zu entwickeln. Was, wenn man Software Entwicklung nicht angeht wie der erste Mensch der das Rad entwickelt, sondern auf dem Wissen und der Erfahrung der letzten 60 Jahre aufbaut.
Produktionsreife Software Entwicklung
Software ist nicht produktionsreif, der gesamte Entwicklungsprozess muss produktionsreif sein, inklusive dem Betrieb und allem drum herum. Software ist kein Stuhl der gebaut wird und dann klaglos seinen Dienst tut. Software ist ein ständig lebendes Produkt, welches kontinuierlich weiterentwickelt werden muss (mindestens Bugfixes und Security Upgrades).
Ein Stillstand der Weiterentwicklung bedeutet das langsame Sterben der Software. Entsprechend muss die Software nicht zu einem bestimmten Zeitpunkt gewisse Kriterien erfüllen. Der gesamte Entwicklungsprozess muss diese Kriterien erfüllen und dauerhaft erhalten.
Indikatoren produktiven Denkens
Respekt vor den Nutzer:innen und den Kosten von Ausfällen
Wenn man länger in der Branche tätig ist, ist es oft überraschend und schockierend mit welcher Nonchalance Entwickler:innen und Systemadministrator:innen bereit sind Ausfälle in Kauf zu nehmen. Deployments werden ohne Ankündigung rausgehauen. Tests werden nicht geschrieben und beim ersten Rollout zerbröselt das neue Feature zwischen den Fingern. Bestehende Funktionalität wird im neuen Release kaputt gemacht. Hauptsache das Scrum-Ziel wurde mit Ach-und-Krach noch erreicht. Vorwärts immer, rückwärts nimmer. Dabei ist es unerheblich ob 20 oder 200 Leute betroffen sind, ob ein Ausfall 50.000€ oder 5 Millionen kostet. Es ist extrem schwer ein Bewusstsein hierfür zu schaffen, ich war in Firmen in denen Angestellte die Aussage brachten “XYZ ist ja eh nicht so wichtig, das ist ja das alte System”. Leider war das alte System die Basis der gesamten Firma und für 100% des Umsatzes verantwortlich. Ohne das “unwichtige” System hätte die Firma innerhalb weniger Tage zu machen können.
Oder, verantwortlich für die Business Intelligence Plattform der gesamten Firma: “Wir sind ja nicht das Hauptprodukt und “nur” BI, ist ja nicht so wichtig”. Die Live Optimierung welche auf der BI Landschaft basierte verbesserte das Firmenergebnis um ca. 20%. Die Ziele der 300 Mitarbeiter:innen waren stark an die Zahlen aus dem BI Tool gekoppelt. Die Geschäftsführung traf ihre Entscheidungen anhand der Zahlen der BI Statistiken.
Der ständige Kampf gegen Unwissen und Ignoranz
Es ist eine ständige Sisyphus-Arbeit das Bewusstsein zu schaffen für die Auswirkungen von Ausfällen, die Wichtigkeit von Systemen und Geschäftsprozessen. Jedes Jahr gehen Angestellte und kommen neue hinzu, externe Mitarbeiter:innen verstärken Projekte. Teams werden umstrukturiert. Bestehende Mitarbeiter:innen werden nachlässig oder waren es schon immer.
Was kann man tun?
- Verständnis aufbauen für die zentralen Geschäftsprozesse der Firma und die Auswirkungen von Ausfällen
- Bei Ausfällen dieses Verständnis immer wieder mit dem Team teilen - nicht als Vorwurf, sondern als reine Fakten und mit starkem Appell, dass Maßnahmen geschaffen werden müssen, diese Art von Ausfällen zukünftig zu verhindern
- Immer wieder das aktuelle Verständnis in Präsentationen und Folien einbauen
- Direkten Kontakt mit den “Opfern” herstellen - beim gemütlichen Feierabend-Bier, etc. wer live mitbekommt, dass Menschen nicht arbeiten können handelt verantwortungsbewusster
Berücksichtigung des “Dreisatzes” Dev, Staging, Produktion
Auch hier bin ich jedes Mal wieder überrascht wie hemdsärmelig teilweise Teams in Firmen agieren die schon Jahrzehnte im Geschäft sind. Da wird die Software das erste Mal richtig in Produktion getestet - von Hand. Dann gibt es noch alle möglichen Zwischenlösungen. So wird zum Beispiel eine Staging Umgebung eingerichtet, jedoch keine Dev-Umgebung. Daher ist die Staging-Umgebung zu instabil um vernünftige Integrationstests zu fahren und faktisch wird wieder auf Prod getestet. Oder es gibt zwar alle drei Umgebungen, aber die Daten der unterschiedlichen Services sind auf Dev und Staging so unzureichend, dass ein Test wieder nicht möglich ist.
In einer Firma hatten wir den Galgenhumor Spruch: “Straight to PROD. Why not!”
Ein vernünftiger Rollout Prozess
Gehen wir davon aus, dass es gelungen ist die drei Umgebungen Dev, Staging und Produktion alle und sinnvoll aufzusetzen. Rollt man Änderungen nun gleichzeitig auf allen 3 Umgebungen aus hat man - wer hats erraten - nichts gewonnen.
Wie wirds gemacht
- Features werden lokal und auf der Dev-Umgebung entwickelt
- Sobald alles funktioniert und der Branch in Main gemerged wurde und Main stabil auf Dev läuft wird ein git-Tag erstellt
- Diese getaggte Version wird nun auf Staging ausgerollt und getestet
- Nach Erfolg wird exakt dieser Tag auf Produktion ausgerollt
Fehler sind unvermeidlich
Teils wird so getan als ob man Fehler vermeiden könnte, oder Fehler optional sind und durch “sauberes” Arbeiten verhindert werden könnten. Dies ist eine Illusion. Standard-Software ist durchzogen von einer unglaublichen Menge an Bugs. Selbst Software im Hochsicherheitsumfeld (Flugzeuge, Raumfahrt, etc.) hat Bugs trotz des unglaublichen Aufwandes der hier getrieben wird diese zu verhindern. Ebenso beim Rollout, etc. Fehler passieren die ganze Zeit und es ist keine Frage ob diese passieren sondern nur wann. Meist wenn man es am wenigsten braucht. Also braucht man Prozesse die diese Fehler frühzeitig sichtbar machen und eine Behebung möglich machen. Beim Rollout müssen alle Betroffenen gewarnt sein: Stichwort Wartungsfenster mit Ankündigung.
Lösungen
- Feste Prozesse sorgen dafür, dass Fehler frühzeitig gefunden werden
- Die Dev und Staging Umgebungen müssen es ermöglichen realistische Tests zu fahren
- Deployments - auch auf Staging - werden angekündigt, sodass alle Nutzer:innen sich darauf einstellen können
Hohe Deploymentgeschwindigkeit trotz sauberer Prozesse
Das Wort “Prozess” klingt unglaublich träge und verstaubt. Das ist was die großen Firmen tun die in der Vergangenheit feststecken denkt man sich, man denkt mit Schrecken an 3 wöchige CAP (Change Advisory Board) Meetings, die außer heißer Luft nichts produzieren. Ein Prozess ist einfach ein definiertes Vorgehen, welches einmalig festgelegt wird, damit Fehler reduziert werden. Ein Abweichen vom Prozess darf nur erfolgen durch Modifikation des Prozesses. Dies verhindert, dass Mitarbeiter:innen in einem Anflug von Selbstüberschätzung Dinge kaputt machen.
Das heißt nicht, dass man ITIL oder anderen existierenden Frameworks folgen muss. Es gibt auch sehr einfache Prozesse die extrem schnell sind.
Beispiel für einen einfachen Prozess
- Entwickelt wird auf Dev in einem Featurebranch
- Nach erfolgreichem Review (alternativ: freies mergen nach eigenem Ermessen der Entwickler:in) wird in den main-Branch integriert
- Auf Staging werden keine Featurebranches deployt, ausschließlich Tags des main-Branches
- Das Deployment auf Staging wird angekündigt (z.B. automatisiert durch die Deployment-Pipeline)
- Auf Staging erfolgt eine Abnahme - welcher Art auch immer - durch die Endnutzer:innen
- Das Deployment auf Production wird angekündigt (z.B. automatisiert durch die Deployment-Pipeline, besser jedoch mit mehr Vorlauf)
- Auf der Produktionsumgebung werden ausschließlich Tags deployt welche auf Staging entsprechend von Nutzer:innen abgenommen wurden
Mögliche Einwände
Hier nur ein paar Beispiele für übliche Einwände. Die Antworten sollen zeigen, dass zwar die Symptome real sind, die Lösung jedoch nicht ist den Prozess aufzuweichen, sondern dafür zu sorgen, dass der Prozess funktioniert. Wenn man mit dieser Perspektive an die Probleme ran geht, dann findet man andere Lösungen, als wenn es nur darum geht “Ausnahmen” zu genehmigen.
- Auf Dev kann ich nicht vernünftig testen, mein Feature-Branch muss auf Staging laufen –> Die Dev Umgebung muss so verändert werden, dass die Tests auf Dev aussagekräftig sind.
- Dann muss ich ja dauernd in main mergen und Tags bauen, wenn ich noch Bugs finde. –> Die Testabdeckung im Code muss verbessert werden, sodass Fehler nicht erst auf Staging bemerkt werden, die Dev Umgebung muss so verändert werden, dass die Tests auf Dev aussagekräftig sind.
- Wenn ich auf die Endnutzer:innen Tests warte komme ich nicht weiter –> in gewissen Rahmen kann der Test auch auchs Endnutzer:innen Perspektive von den Entwickler:innen durchgeführt werden.
Betrieb wird mit betrachtet
Oft liegt der Fokus ausschließlich auf der Entwicklung. Features werden am laufenden Band produziert, doch wer kümmert sich darum, dass die Software auch läuft und wirklich den geplanten Mehrwert liefern kann?
Es braucht ein Betriebskonzept welches die wichtigsten Fragen beantwortet:
- Wie stellt man fest, dass etwas nicht funktioniert (Best-Case: Monitoring, Worst-Case: Leute beschweren sich)
- Wer kümmert sich darum Bugs nachzuverfolgen/nachzustellen
- Gibt es einen Vertretungsplan, wenn diese Person ausfällt
- Es werden dauerhaft Ressourcen durch Betrieb gebunden, das muss beachtet und eingeplant werden
Monitoring & Alerting
Um einen reibungslosen Betrieb zu gewährleisten ist ein Monitoring der wichtigsten Applikations-Kennzahlen und System-Kennwerte unerlässlich.
Bei außerplanmäßigen Abweichungen soll alarmiert werden, damit das Betriebsteam proaktiv reagieren kann.
Backup
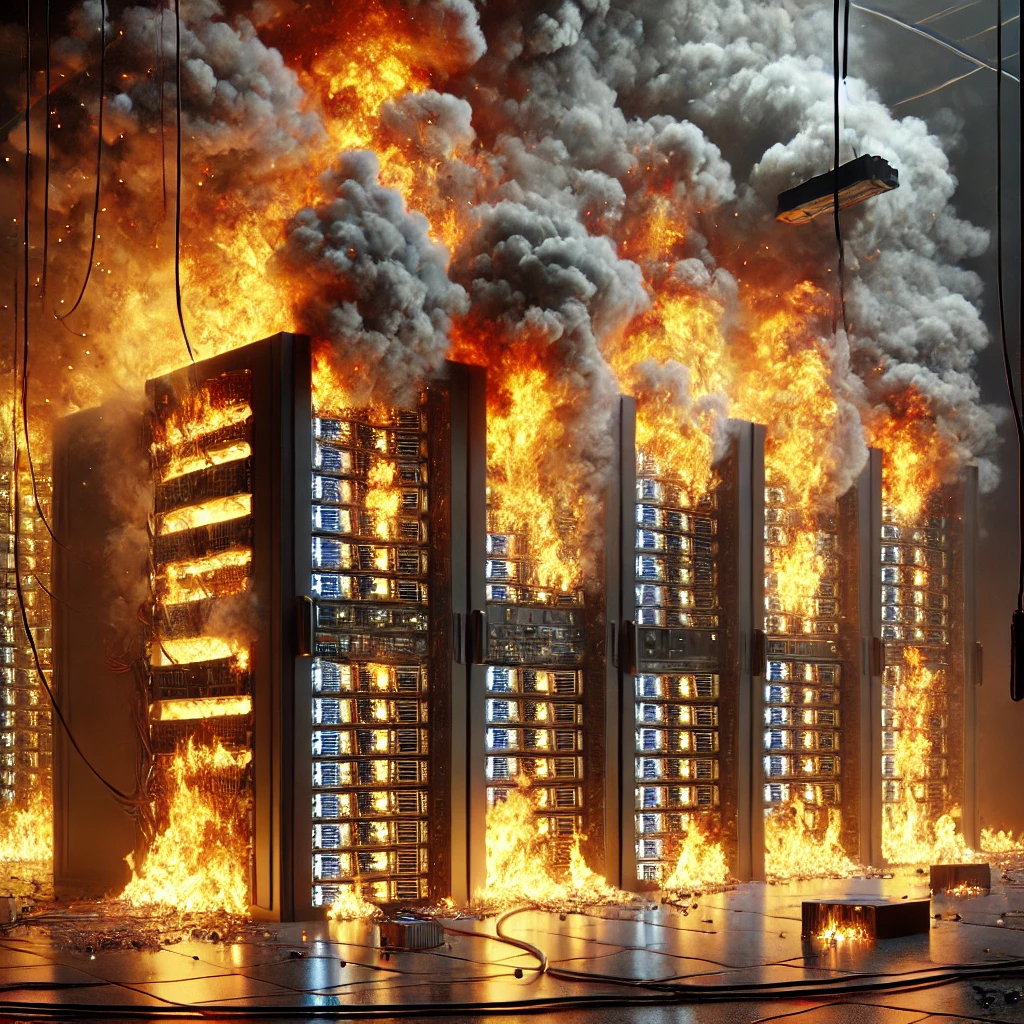
Der Service schnurrt, die User sind zufrieden, es könnte nicht schöner sein. Dann brennt das Rechenzentrum ab ( Feuer bei OVH ).
Wie bei Fehlern sind auch Ausfälle und kompletter Datenverlust unvermeidlich. Es wird passieren, entweder technisch, durch Mitarbeiter:innen oder externe Angreifer:innen.
Je größer der Mehrwert, desto größer der Schaden im Worst-Case Szenario. Wenn eine Applikation kein Backup benötigt ist sie sinnlos - oder nur Erfüllungsgehilf:in für eine andere Applikation, welche dann aber entsprechendes Backup benötigt.
Bewusstsein schaffen für:
- Was sind unsere wichtigsten Daten und Abläufe
- Wie können wir im Fehlerfall den Schaden gering halten
- Regelmäßiges Durchspielen des Ernstfalls. Der Klassiker: wir haben ein Backup, aber wir haben noch nie versucht den Restore durchzuführen. Ein Freund von mir meinte mal: “Niemand will ein Backup … die Leute wollen den Restore!”. Oder anders formuliert: Ohne erfolgreichen Restore ist ein Backup absolut wertlos.
Wert und ständige Kommunikation
Die Wertschöpfung einer Applikation und die positiven Effekte sollten beständig und transparent nach innen und außen kommuniziert werden. Hier geht es nicht darum Fake-News zu verbreiten und Luft-Schlösser zu bauen, sondern klar und realistisch die Wertschöpfung zu kommunizieren.
Es ist wichtig in ständigem Kontakt mit den Nutzer:innen und Profiteur:innen der Applikation zu bleiben. Durch direkte Kontakte, regelmäßige - bevorzugt auch lockere und entspannte - Treffen, Chat-Rooms und Ticket-Systeme. Es muss klar sein, wenn der gewünschte Mehrwert nicht mehr der Realität entspricht. Wenn die Nutzer:innen unzufrieden werden.
Neutralität der Sache
Wir sind Menschen und keine Vulkanier (siehe Star Trek, Mr. Spock) wir handeln und verhalten uns nicht rein rational. Wenn jemand Fragen stellt, sich beschwert, Vorgänge kritisiert so haben viele Menschen instinktiv das Bedürfnis sich zu verteidigen und die vorgebrachten Themen kleinzureden, zu ignorieren oder wegzudiskutieren.
Wir sollten versuchen zuzuhören und versuchen neutral zu bewerten ob eine Wahrheit in den Beschwerden oder Vorschlägen steckt. Die Diskussionen gehen um eine Sache und die Realität lässt sich nicht leugnen.
Wir können erklären warum wir die Realität nicht ändern können, oder wir können mehr Ressourcen aufwenden um eine Änderung möglich zu machen - mit potentiell negativen Konsequenzen für andere Projekte/Features da Zeit gebunden wird.
Letztlich ist es am Ende eine reine Sache der Priorisierung.
Statt:
- Statt “Ich habe keine Zeit es dir zu erklären, mach es einfach so wie ich dir sage”: Wir haben das aus Grund XYZ so gemacht, hier findest du Informationen. Das war der einfachste Weg, falls du eine bessere Lösung findest, gib gerne Bescheid, damit wir das neu evaluieren können.
- Statt “Das muss so sein”: Aus Gründen XYZ ist die Situation gerade so. Wenn wir Feature ABC zurückstellen können wir versuchen die Situation zu verbessern.
- Statt “Warum stellst du so Fragen”: Weiß ich gerade nicht aus dem Kopf, ich schicke dir später die Informationen (und dann auch wirklich schicken!)
Wir wollen alle das Gleiche: Einen Mehrwert schaffen für andere Leute und hierbei das Beste Ergebnis erzielen, was für uns möglich ist.
Keine Lust!
Ich bin sicher, bei den Wörtern “Prozess” und “Backup + Restore” hat die Hälfte die den Artikel liest innerlich bereits gekotzt. Die Etablierung von Prozessen und das einrichten von Backups und regelmäßiges testen von Restores ist ungefähr so spannend und beliebt wie die Reinigung einer Latrine.
Das muss jedoch nicht so sein. Es ist eine Freude eine Applikation und Systeme zu sehen die wie ein Kätzchen schnurren. Es ist toll, wenn die Nutzer:innen zufrieden sind und einem immer wieder sagen wie schön es ist sich endlich auf ein System verlassen zu können. Wenn man den direkten positiven Mehrwert der eigenen Arbeit erlebt. Es ist befriedigend zu wissen, dass man im Katastrophenfall die Anwendung innerhalb von ein paar Stunden from-scratch wieder hochziehen kann. Nicht theoretisch, vielleicht, sondern sicher. Weil man es ausprobiert hat. Viele Male.
Das Management kann hier viel beitragen, indem saubere Vorgänge nicht als Feature-Bremsen gesehen werden, sondern als essentieller Bestandteil den geschafften Wert anderen Menschen zugänglich zu machen und dauerhaft zu erhalten.