
There is no silver bullet – warum jede Entscheidung ein Kompromiss ist
1. Die Wunderwaffe, die es nicht gibt
Im Volksglauben gibt es genau ein Mittel gegen Werwölfe: die Silberkugel. Ein Schuss, und das Problem ist gelöst. Fred Brooks hat dieses Bild 1986 in seinem Aufsatz „No Silver Bullet“ auf die Softwareentwicklung übertragen: Es gibt keine einzelne Technik, die Softwareentwicklung auf einen Schlag um ein Vielfaches schneller, einfacher oder zuverlässiger macht.
Trotzdem begegnet mir die Suche nach der Silberkugel ständig. Kubernetes soll die Betriebsprobleme lösen, Microservices die Wartbarkeit, die Cloud die Kosten, KI die Entwicklungsgeschwindigkeit. All das kann helfen – aber nichts davon gibt es umsonst.
2. Jeder Vorteil hat seinen Preis
Jede Entscheidung, die man in Architektur und Betrieb trifft, verschiebt Gewichte. Man gewinnt auf der einen Seite und bezahlt auf der anderen. Das ist kein Zeichen einer schlechten Entscheidung, sondern schlicht Physik. Schlecht wird eine Entscheidung erst, wenn man den Preis nicht kennt – oder so tut, als gäbe es keinen.
Ein paar Beispiele, die mir in Projekten immer wieder begegnen:
| Entscheidung | Vorteil | Preis |
|---|---|---|
| Mehr Redundanz | Ausfallsicherheit | Mehr Komplexität, höhere Kosten, Fragen der Datenkonsistenz |
| Caching | Geschwindigkeit, entlastete Datenbank | Veraltete Daten, schwierige Invalidierung |
| Microservices | Unabhängige Deployments und Skalierung | Verteiltes System: Netzwerkfehler, Tracing, Konsistenz |
| Strikte Resource Limits | Vorhersagbarkeit, Schutz der Nachbarn | Weniger Spielraum bei Lastspitzen, Throttling |
| Autoscaling | Passt sich der Last an | Kaltstarts, schwankende Kosten, schwerer vorhersagbar |
| Aggressive Health Checks | Fehler werden schnell erkannt | Fehlalarme und Neustart-Kaskaden unter Last |
| Normalisiertes Datenmodell | Keine Redundanz, klare Konsistenz | Viele Joins, langsamere Leseabfragen |
3. Das CAP-Theorem – der Klassiker unter den Kompromissen
Besonders schön sieht man das Prinzip bei verteilten Systemen. Das CAP-Theorem sagt: Ein verteiltes System kann nicht gleichzeitig Consistency (alle Knoten liefern denselben, aktuellen Stand), Availability (jede Anfrage bekommt eine Antwort) und Partition Tolerance (das System funktioniert weiter, wenn das Netzwerk zwischen den Knoten ausfällt) garantieren.
Oft wird das als „wähle zwei aus drei“ zitiert. Genauer ist: Netzwerkausfälle passieren, man kann sie sich nicht aussuchen. Die eigentliche Frage lautet also: Was soll das System tun, wenn die Verbindung zwischen den Knoten abreißt?

Ein Onlineshop, der „noch 5 auf Lager“ anzeigt, obwohl es nur noch 4 sind, ist ärgerlich, aber verkraftbar – hier ist Verfügbarkeit wichtiger. Ein Kontostand, der doppelt abgebucht werden kann, ist es nicht – hier gewinnt die Konsistenz. Dieselbe Frage, zwei richtige Antworten, je nach Kontext.
Auch Kafka stellt einen vor diese Wahl: Mit acks=all und min.insync.replicas=2 lehnt der Broker Schreibzugriffe
lieber ab, als Daten auf nur einer Kopie zu speichern. Und unclean.leader.election.enable entscheidet, ob eine
Partition lieber nicht verfügbar ist oder mit einem veralteten Replikat weiterläuft und dabei Daten verliert.
Übrigens hört der Kompromiss nicht auf, wenn das Netzwerk funktioniert. Die Erweiterung PACELC ergänzt: Auch im Normalbetrieb muss man zwischen Latenz und Consistency abwägen. Jede Bestätigung durch ein weiteres Replikat macht die Daten sicherer – und die Antwort langsamer.
4. Stabilität oder Geschwindigkeit?
Ein Beispiel aus dem Alltag vieler Teams ist der Release-Prozess. Wer auf Stabilität optimiert, arbeitet mit Release-Branches, Tags und geplanten Releases mit manuellen Tests. Man weiß genau, was ausgeliefert wird, und Rollbacks sind sauber. Der Preis: langsamere Iteration und viel Verwaltungsaufwand.
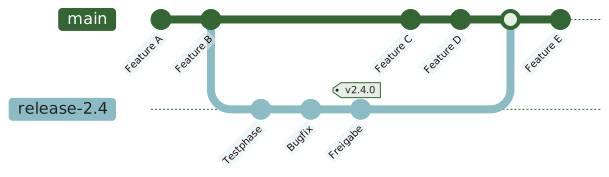
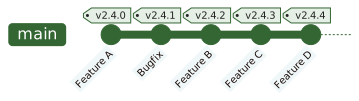
Wer auf Geschwindigkeit optimiert, arbeitet auf einem einzigen Branch, und jede Änderung geht automatisch in Produktion. Das Feedback kommt schnell, die Pipeline macht die Arbeit. Der Preis: Man setzt alles auf Testabdeckung und Automatisierung – und was durchrutscht, rutscht direkt in Produktion.
Kann man nicht beides haben? Doch – aber auch das hat seinen Preis. Feature Flags, Canary-Releases, gutes Monitoring und automatische Rollbacks machen schnelle Releases sicher. Dafür muss man sie aufbauen, betreiben und verstehen. Die obere rechte Ecke ist erreichbar, aber teuer erkauft.
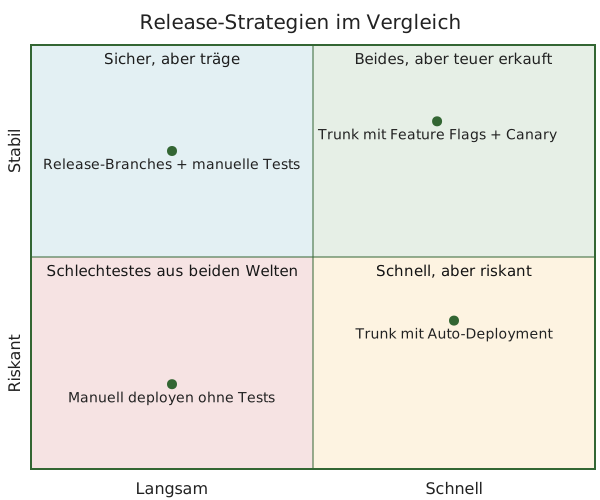
Keiner der Ansätze ist falsch. Ein reguliertes Unternehmen braucht vielleicht den ersten, ein junges Startup würde mit ihm nicht überleben.
5. Wenn alle alles wollen
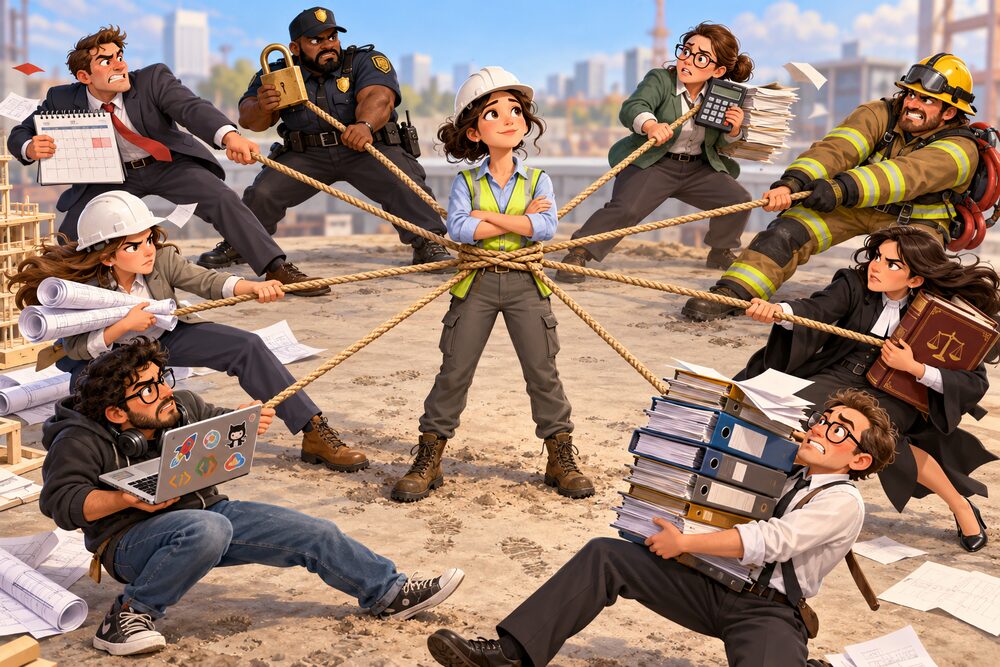
Richtig spannend wird es, wenn die Kompromisse nicht nur technisch sind, sondern Menschen dahinterstehen. Der Fachbereich möchte jede Woche neue Features, der Betrieb am liebsten gar keine Änderungen mehr. Die Security will jede Bibliothek sofort patchen und gleichzeitig alles abschotten, was wiederum jedes Deployment verlangsamt. Das Controlling möchte die Server bis zum Anschlag auslasten, die Nutzer erwarten, dass alles immer sofort antwortet – auch in der Lastspitze, für die man die Reserve gebraucht hätte. Der Datenschutz fordert, so wenig Daten wie möglich zu speichern und sie früh zu löschen, die Revision will alles jahrelang nachvollziehen können. Die Entwicklungsteams wollen ihre Technologien frei wählen, die Architektur hätte gern eine einheitliche Plattform. Und alle wollen das Ganze bis zum nächsten Quartal – natürlich ohne zusätzliches Budget.

Jede dieser Anforderungen ist für sich genommen berechtigt. Zusammen sind sie unerfüllbar. Wer versucht, allen gleichzeitig gerecht zu werden, baut ein System, das alles ein bisschen und nichts richtig kann.
6. Wie man klug abwägt
Wenn es die Silberkugel nicht gibt, bleibt nur eines: bewusst entscheiden. Was mir dabei hilft:
- Ziele priorisieren, nicht nur sammeln. „Alles ist wichtig“ ist keine Priorisierung. Eine klare Reihenfolge, etwa „Datensicherheit vor Verfügbarkeit vor Time-to-Market“, macht viele Entscheidungen fast von selbst.
- Den Kontext ernst nehmen. Was in einem Projekt die perfekte Lösung war, kann im nächsten genau falsch sein. Best Practices sind Ausgangspunkte, keine Gesetze.
- Den Preis benennen. Zu jeder Entscheidung gehört die Frage: Was geben wir dafür auf? Wer den Nachteil kennt, kann ihn überwachen und abfedern.
- Umkehrbarkeit beachten. Entscheidungen, die sich leicht rückgängig machen lassen, darf man schnell treffen. Bei Datenmodell, Datenbank oder Cloud-Anbieter lohnt es sich, gründlich nachzudenken.
- Entscheidungen dokumentieren. Ein kurzer Architecture Decision Record mit Alternativen und bewusst in Kauf genommenen Nachteilen erspart später lange Diskussionen darüber, „wer sich das denn ausgedacht hat“.
- Regelmäßig überprüfen. Last, Team und Anforderungen ändern sich. Was vor zwei Jahren der richtige Kompromiss war, ist es heute vielleicht nicht mehr.
Fazit
Es gibt keine Silberkugel – weder in der Technik noch in der Organisation. Jeder Vorteil hat einen Preis, und die eigentliche Kunst besteht nicht darin, die perfekte Lösung zu finden, sondern darin, den Preis zu kennen, ihn bewusst zu bezahlen und die Entscheidung wieder aufzugreifen, wenn sich die Lage ändert.